如需了解开发联系电话:18310199838
生鲜出库的准确率,很少由单一技术决定。它更像是订单信息、商品形态、人员动作与系统判断之间的一次次对齐。智能分拣的价值在于,把这些对齐动作从“靠人记住”变成“由系统约束”,让准确率长期稳定在近乎满分的区间。
准确率的上限,通常不在设备端
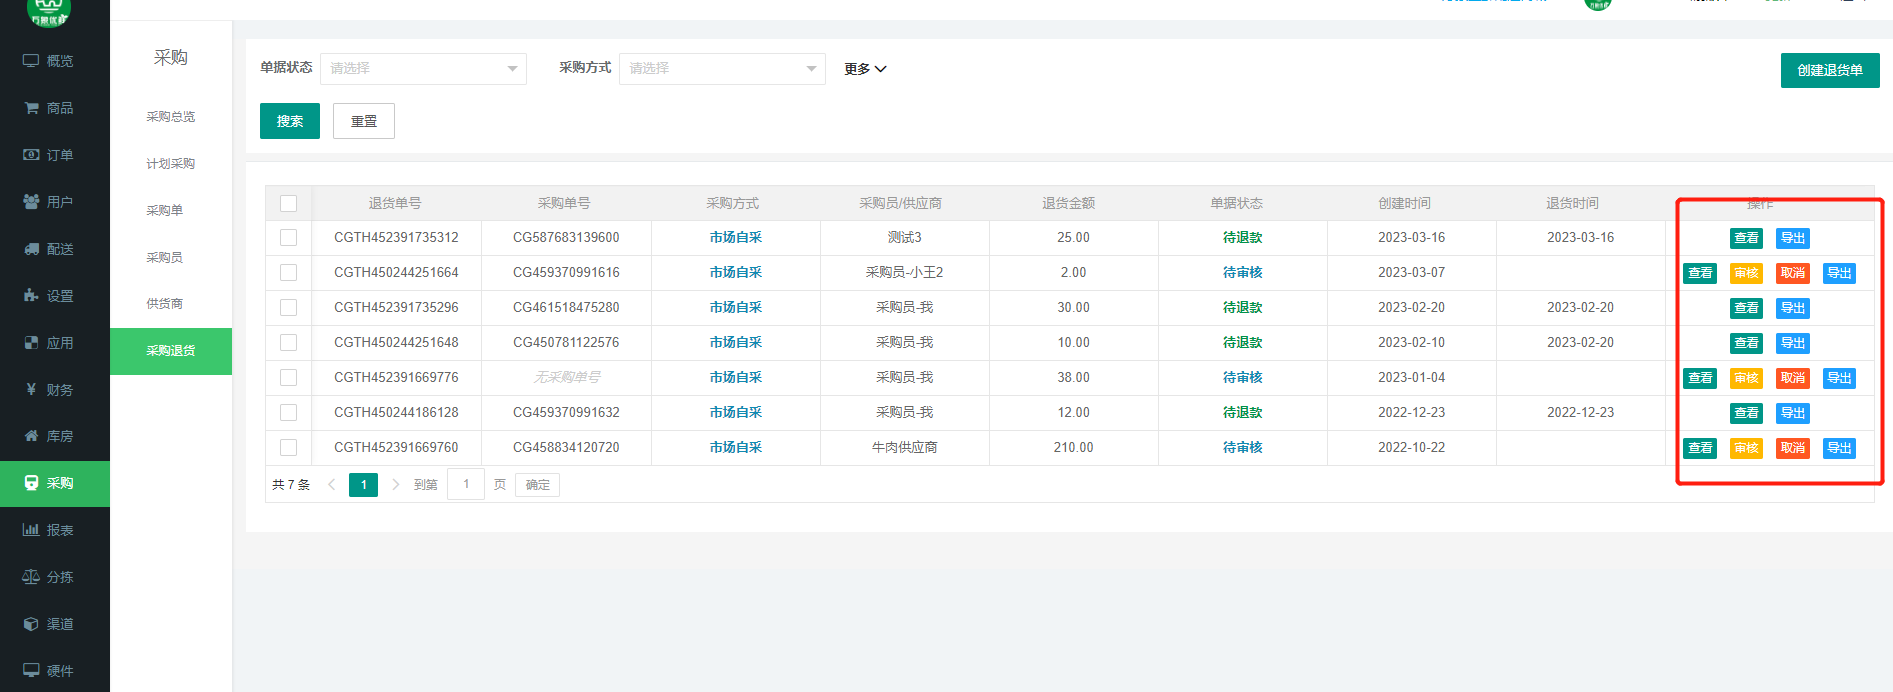
不少仓库引入自动分拣线后发现,差错并未同步下降。原因常常在上游:商品档案里存在多个相似品名,同一SKU对应多种包装规格,临时改单没有及时回流到分拣任务。设备执行得再快,也只是把上游的不确定放大。智能分拣真正解决的,是判断权归属问题——把“这一单该拿哪一件”的判断,从个人经验转移到规则与数据之上。
智能分拣改变的三件事
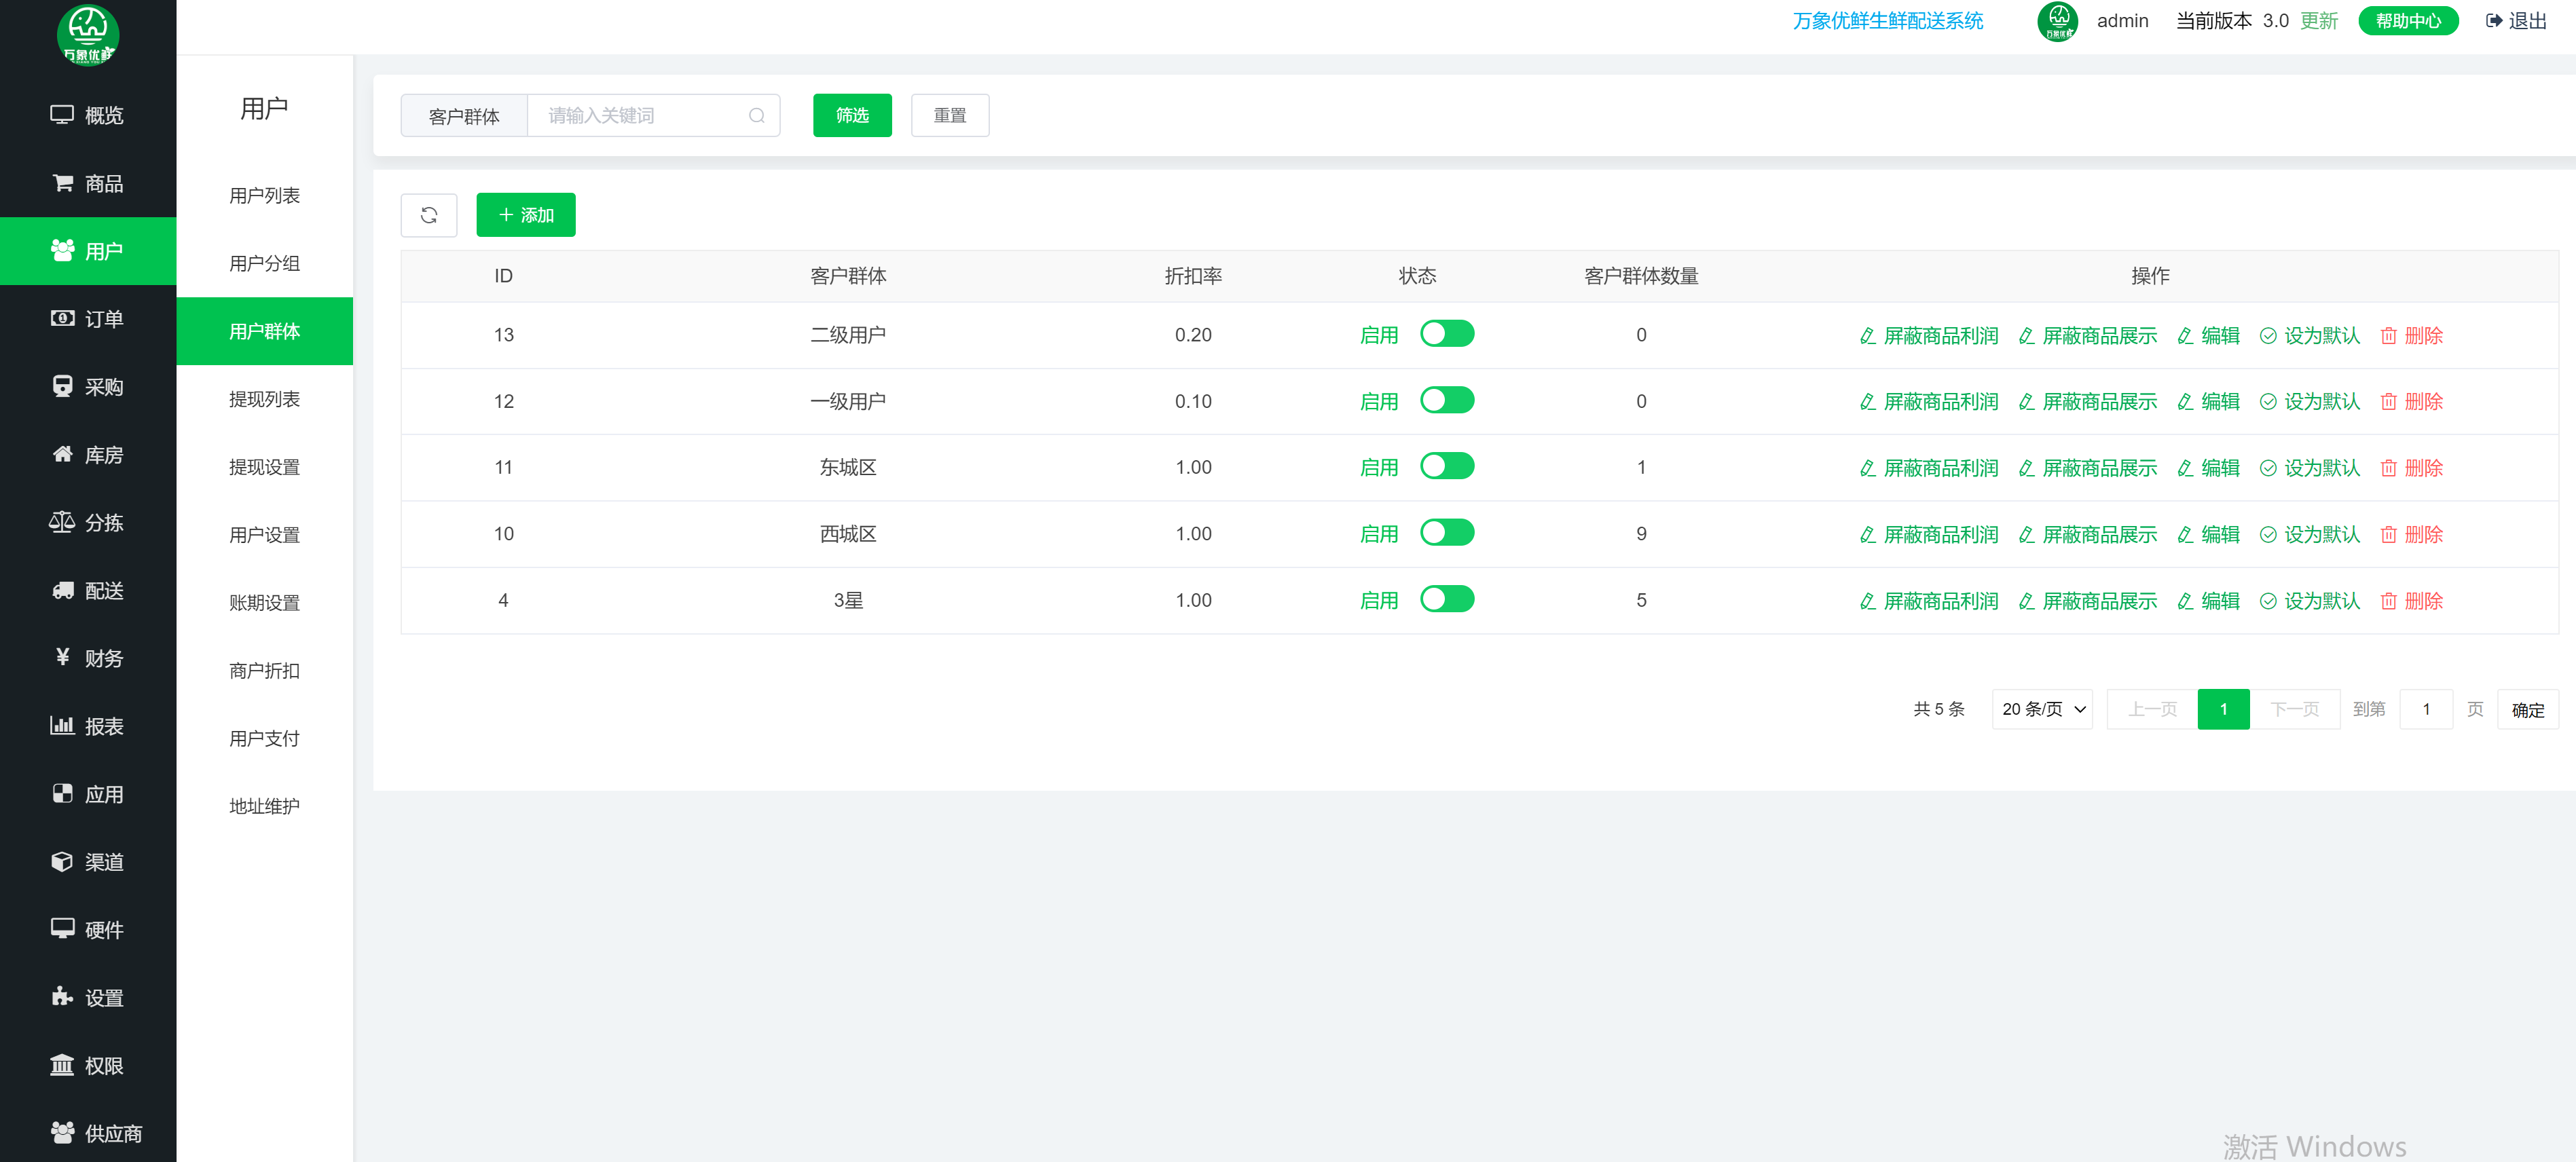
识别:从“看外形”到“读身份”
扫码、称重与视觉核验组合使用,让商品在进入分拣位时就有了明确身份。对生鲜而言,外观相近的品类尤其需要这种确认,避免“看着像”带来的误拿。
分配:从“凭经验”到“按规则”
分拣任务按订单结构、温区要求与装箱容量自动拆分,减少同一门店订单被拆散、不同温区商品混装的情况。规则稳定,结果才稳定。
复核:从“事后追查”到“过程留痕”
每一次投递都留下时间、位置与操作记录,异常可在装车前被发现并回补,而不是等到门店收货才暴露。
近乎满分需要的前提
- 主数据干净:品名、规格、条码、温层一一对应,不存在重码与近似名称。
- 订单与库存同步:改单、缺货、替换规则实时下发至分拣任务。
- 异常有闭环:缺货、破损、超重都有明确的处理路径与责任人。
- 角色清晰:补货、分拣、复核、装车各环节的交接标准写进作业规范。
现场可以着手的三步
- 先梳理商品档案,把相似品做醒目标识与物理隔离。
- 选出差错集中的品类做试点,跑通规则后再横向复制。
- 把复核结果纳入日常复盘,让规则随业务变化持续校准。
近乎满分不是一次冲刺的结果,而是系统、流程与人反复对齐之后的常态。智能分拣提供的是基础能力,真正决定上限的,是运营者是否愿意把这些基础动作长期做扎实。
如需了解详情联系电话:18310199838