如需了解开发联系电话:18310199838
订单高峰期的卡顿,很少是某一刻突然发生的。更常见的情况是:日常资源余量被逐步占用,连接数与队列缓慢堆积,某个下游接口的响应时间悄悄抬升,直到大促当天集中暴露。因此,稳定运维不卡顿不是一句状态描述,而是一套可被提前验证的运行能力;全程护航企业订单高峰期,也从峰值当天开始,提前到日常的每一天。
一、把“不卡顿”变成可读的指标
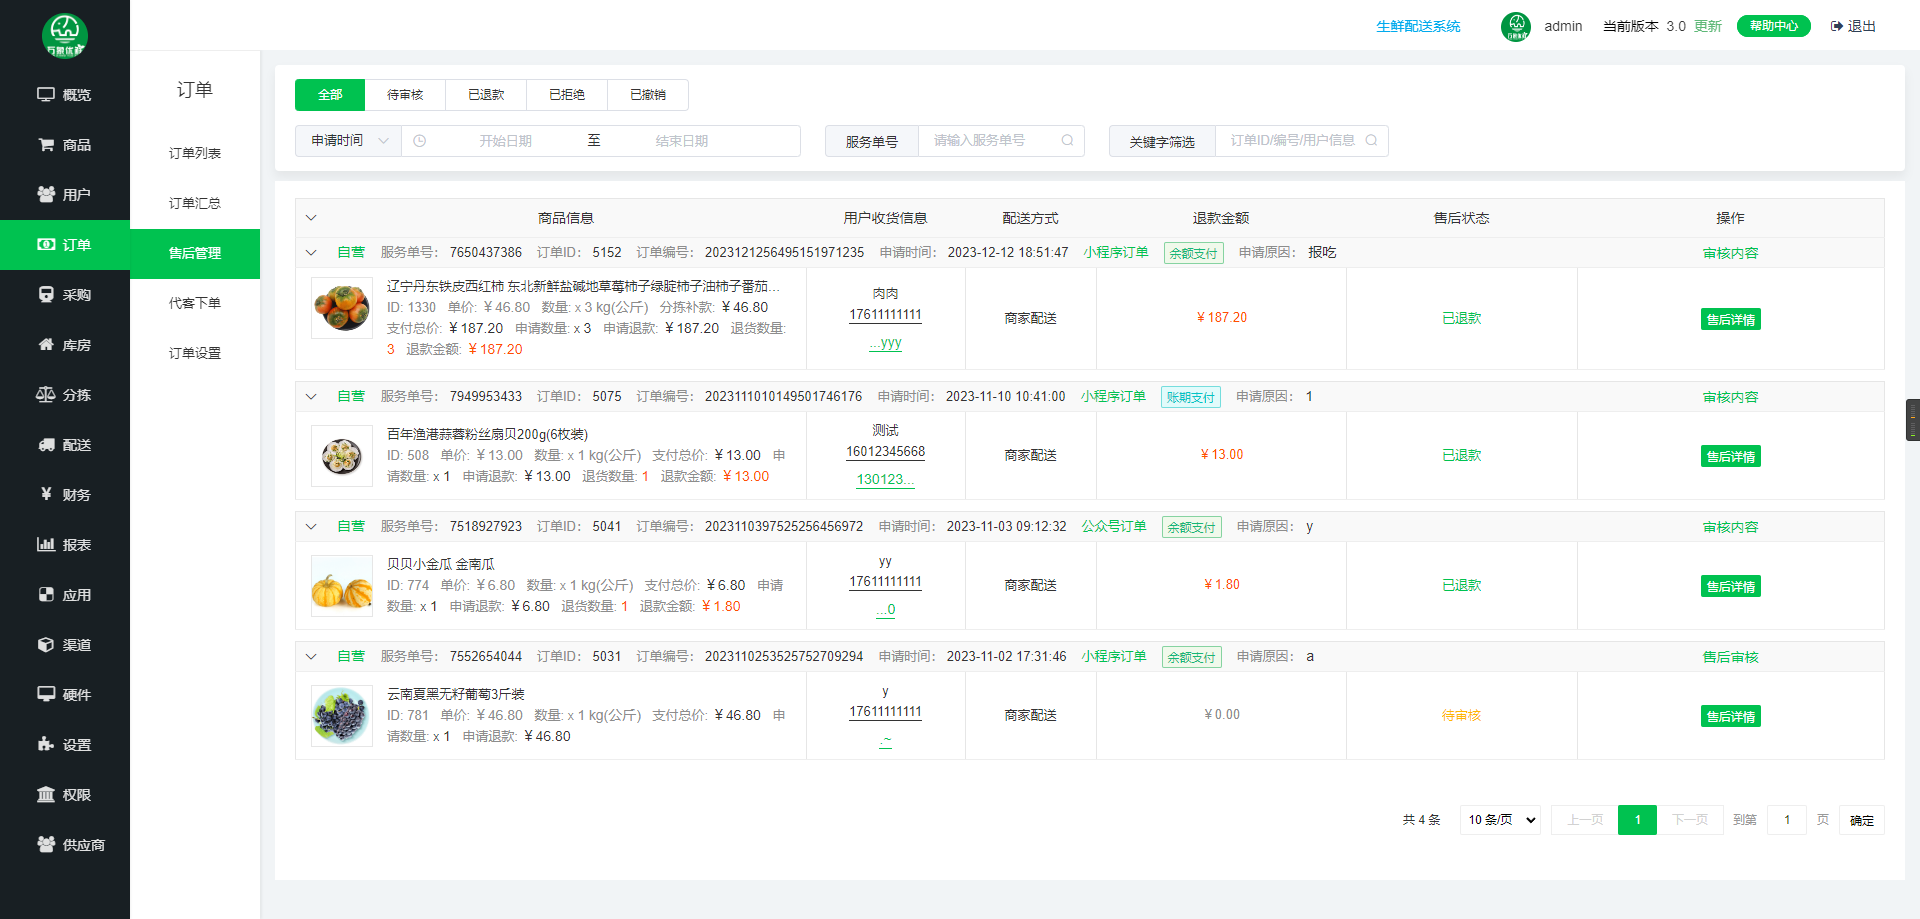
“不卡顿”如果只靠体感判断,就无法提前干预。建议为关键链路建立一组日常观测指标,并明确正常区间:
- 接口响应时间的分位值,而不只是平均值;
- 错误率与超时率的短周期波动;
- 消息队列积压量与消费延迟;
- 数据库连接数、慢查询数量与锁等待;
- CPU、内存、带宽等资源水位的趋势线。
指标的价值在于趋势。单点数值正常不代表安全,连续多日的缓慢爬升才是需要处理的信号。
二、分层识别瓶颈,避免“一刀切扩容”

订单链路的瓶颈往往集中在少数环节。接入层关注连接数与限流策略,应用层关注线程池与依赖超时设置,数据层关注写入热点与索引效率。分层排查的好处是,扩容与优化能落在真正吃紧的位置,减少无效投入。对非核心功能预设降级方案,也可以在峰值时优先保障下单与支付主链路。
三、用节奏管理峰值,而不是硬扛
| 阶段 | 关注重点 |
|---|---|
| 峰值前 | 容量评估、压测验证、扩容与预案确认 |
| 峰值中 | 值守监控、限流降级、变更冻结 |
| 峰值后 | 资源回收、问题复盘、预案修订 |
节奏清晰,团队在高压时段的动作才不会变形。稳定运维不卡顿依赖的是流程的确定性,而非临场发挥。
四、人是护航闭环的一部分
值班表、升级路径、决策授权需要在峰值前明确到人。谁来判断是否限流,谁有权回滚,多久未恢复则升级,这些问题在平时讨论清楚,峰值时才不会消耗在沟通上。
稳定不是运气,而是日常纪律在关键时刻的自然结果。
当指标可读、瓶颈清晰、节奏固定、责任明确,订单高峰期的全程护航就有了可预期的落点。
如需了解详情联系电话:18310199838